Utiliser les Web Crawlers
Avec les Web Crawlers, vous pouvez collecter des informations à partir d'un site Web automatiquement en utilisant l'URL du domaine. Toute page découvrable dans le domaine sera automatiquement ajoutée à la base de connaissances. Pour les sites Web dont le contenu est fréquemment mis à jour, vous pouvez planifier des analyses périodiques pour ajouter les informations et contenus les plus récents des pages nouvellement ajoutées à la base de connaissances. De plus, vous pouvez spécifier certains mots-clés ou chemins d'accès dans le modèle d'analyse pour extraire uniquement des sections spécifiques de votre site Web.
Modèles de crawl
Les Modèles permettent des restrictions rapides et faciles sur les pages analysées ou traitées en fonction de simples correspondances de chaînes d'URL. Par exemple, pour analyser uniquement les pages de la catégorie « sports » sur http://www.example.com/sports/heres-a-sports-article.html, vous pouvez spécifier un modèle de crawl de /sports/ (l'inclusion de barres obliques garantit la précision et évite de correspondre à une chaîne « sports » ailleurs dans l'URL).
En utilisant un modèle de crawl, vous pouvez limiter le crawl à un sous-domaine particulier. Par exemple, lors d'un crawl commençant à un domaine spécifique, vous pouvez entrer un modèle de crawl pour empêcher le crawl de liens indésirables.
Dans une configuration de Web Crawl, vous pouvez entrer plusieurs modèles pour correspondre à plusieurs chaînes en plaçant chaque modèle individuel sur une nouvelle ligne.
Ce sont les modèles de crawl disponibles :
Limitation des correspondances au début des URL
Utilisez le caractère de caret (^) pour restreindre les correspondances de modèle au début d'une URL. Par exemple, un modèle de traitement de ^https://example.com limitera le traitement uniquement aux pages dont les URL commencent par https://example.com.
Modèles de correspondance négative
Utilisez le point d'exclamation (!) pour une « correspondance négative » pour exclure explicitement les pages d'être analysées ou traitées.
Expressions régulières pour le crawl et le traitement
Pour un contrôle précis de vos correspondances d'URL de crawl ou de traitement, vous pouvez créer une expression régulière (regex) pour analyser ou traiter exclusivement les URL qui correspondent à votre expression définie. Par exemple, pour traiter les pages à https://example.com/ sous le chemin « /crawl » et contenant le terme « regex », vous pouvez utiliser une regex de traitement similaire à : \\/crawl.*?regex.
Le crawlbot utilise un moteur d'expression régulière personnalisé pour des performances optimales lors de l'évaluation des pages. En termes de syntaxe de classe de caractères, couramment utilisée dans l'analyse Crawlbot, le crawlbot prend en charge tous les caractères de traitement ASCII et la plupart des raccourcis Perl/Tcl.
Modèle de traitement HTML
Le crawl permet de limiter les pages traitées en fonction de modèles de traitement HTML, qui examineront uniquement la source brute et n'exécutent pas JavaScript/AJAX pendant l'analyse. Cependant, l'inconvénient de cette option est la vitesse de crawl.
Si vous souhaitez une vitesse de crawl plus rapide, vous devez utiliser le crawl et le traitement regex.
Quand utiliser un Crawler
Le crawler est conçu pour extraire des informations structurées et de haute valeur du Web. Il fonctionne mieux dans les scénarios où les données sont accessibles au public et mises à jour régulièrement.
Meilleurs cas d'utilisation
- Actualités et médias – Extraire des articles de sites comme BBC News
- Données financières – Collecter des informations de marché à partir de sites boursiers tels que NASDAQ
- E-commerce – Collecter les listes de produits, les avis et les tarifs des places de marché
- Ressources de connaissance – Capturer les articles de blog, les discussions de forum ou le contenu FAQ pour enrichir votre base de connaissances.
Quand ne pas utiliser le Crawler
Évitez de faire un crawl dans ces situations pour éviter les erreurs ou les problèmes de conformité :
- Authentification requise – Sites Web nécessitant des identifiants de connexion (p. ex., LinkedIn).
- Tableaux de bord hautement dynamiques – Les tableaux de bord en temps réel (comme les cotations boursières en direct) peuvent ne pas produire de résultats complets.
- Surcharge excessive du site – Respectez les politiques d'utilisation de chaque site – consultez toujours le fichier
robot.txtavant de faire un crawl.
Créer un nouveau Crawler
-
Dans votre projet EKB, accédez à la Base de connaissances.
-
Dans la base de connaissances, cliquez sur l'icône engrenage dans le coin supérieur droit.
-
Allez à l'onglet Crawlers.
-
Cliquez sur + Créer nouveau.
-
Dans la section Entrée :
 a. Entrez un nom pour votre crawler.
b. Fournissez l'URL de départ, le lien du site Web que vous souhaitez analyser. Il s'agit du lien initial auquel accède le crawler. De là, le crawler explore les pages Web et les liens disponibles sur le site Web. -
Dans la section Paramètres du Crawler :

- Limiter au domaine racine – Cela définit le crawler pour se concentrer uniquement sur le domaine racine, rationalisant l'extraction des informations pertinentes.
- Télécharger les fichiers – Activez cette option si vous souhaitez que le crawler télécharge et traite les fichiers trouvés lors du crawl.
- Nombre maximal de pages à analyser – Définissez le nombre maximal de pages à analyser, pour optimiser l'utilisation des ressources et l'efficacité.
- Profondeur maximale – Définissez la profondeur maximale à analyser à partir de l'URL de départ (c.-à-d., le nombre de liens à suivre en profondeur).
- Stratégie de crawl – Choisissez comment le crawler détermine les priorités des pages à visiter en premier.
- Best First – Si vous sélectionnez cette option, vous devez configurer les mots-clés que le crawler doit utiliser pour trouver ces pages et le poids de ces mots-clés.
- Mots-clés pour Best First – Les pages contenant les mots-clés configurés dans cette zone de texte seront analysées en premier. Entrez un mot-clé par ligne.
- Poids des mots-clés – Configurez le poids des mots-clés pour la correspondance des mots-clés ; plus la valeur est élevée, plus elle priorise la correspondance des mots-clés.
- Breadth First – Cette méthode priorise la visite de toutes les pages directement liées à une page actuelle avant d'approfondir.
- Depth First – Cette méthode priorise l'exploration aussi profondément que possible le long d'un seul chemin de liens avant de revenir en arrière et d'explorer d'autres chemins.
- Best First – Si vous sélectionnez cette option, vous devez configurer les mots-clés que le crawler doit utiliser pour trouver ces pages et le poids de ces mots-clés.
- Limiter aux domaines – Restreindre le crawler à des domaines spécifiques au lieu d'analyser tous les sous-domaines dans le domaine racine. Entrez un domaine par ligne ou laissez vide pour analyser tous les sous-domaines.
- Limiter aux modèles – Entrez les modèles de crawl que vous souhaitez que le crawler utilise. Entrez un modèle de crawl par ligne.attentionSi vous utilisez plusieurs modèles de crawl, voici la hiérarchie :
1. Regex
2. Correspondances négatives
3. Tous les autres modèles.
-
Dans la section Planification, définissez la fréquence et l'heure des crawls planifiés :

- Crawl activé – Activez cette option pour définir le calendrier de crawl.
- Répéter tous les n jours – Définissez le nombre de jours pour lequel vous souhaitez que le crawl s'exécute. Par exemple :
- Quotidien =
1 - Hebdomadaire =
7 - Bi-hebdomadaire =
14 - Mensuel =
30
- Quotidien =
- Prochain calendrier – En fonction du nombre de jours que vous entrez, vous verrez la prochaine date de crawl.
-
Une fois que vous avez terminé la configuration de votre crawl Web, cliquez sur Crawl Now pour démarrer le premier crawl. Vous serez redirigé vers la page de configuration du nouveau crawler avec les onglets suivants :
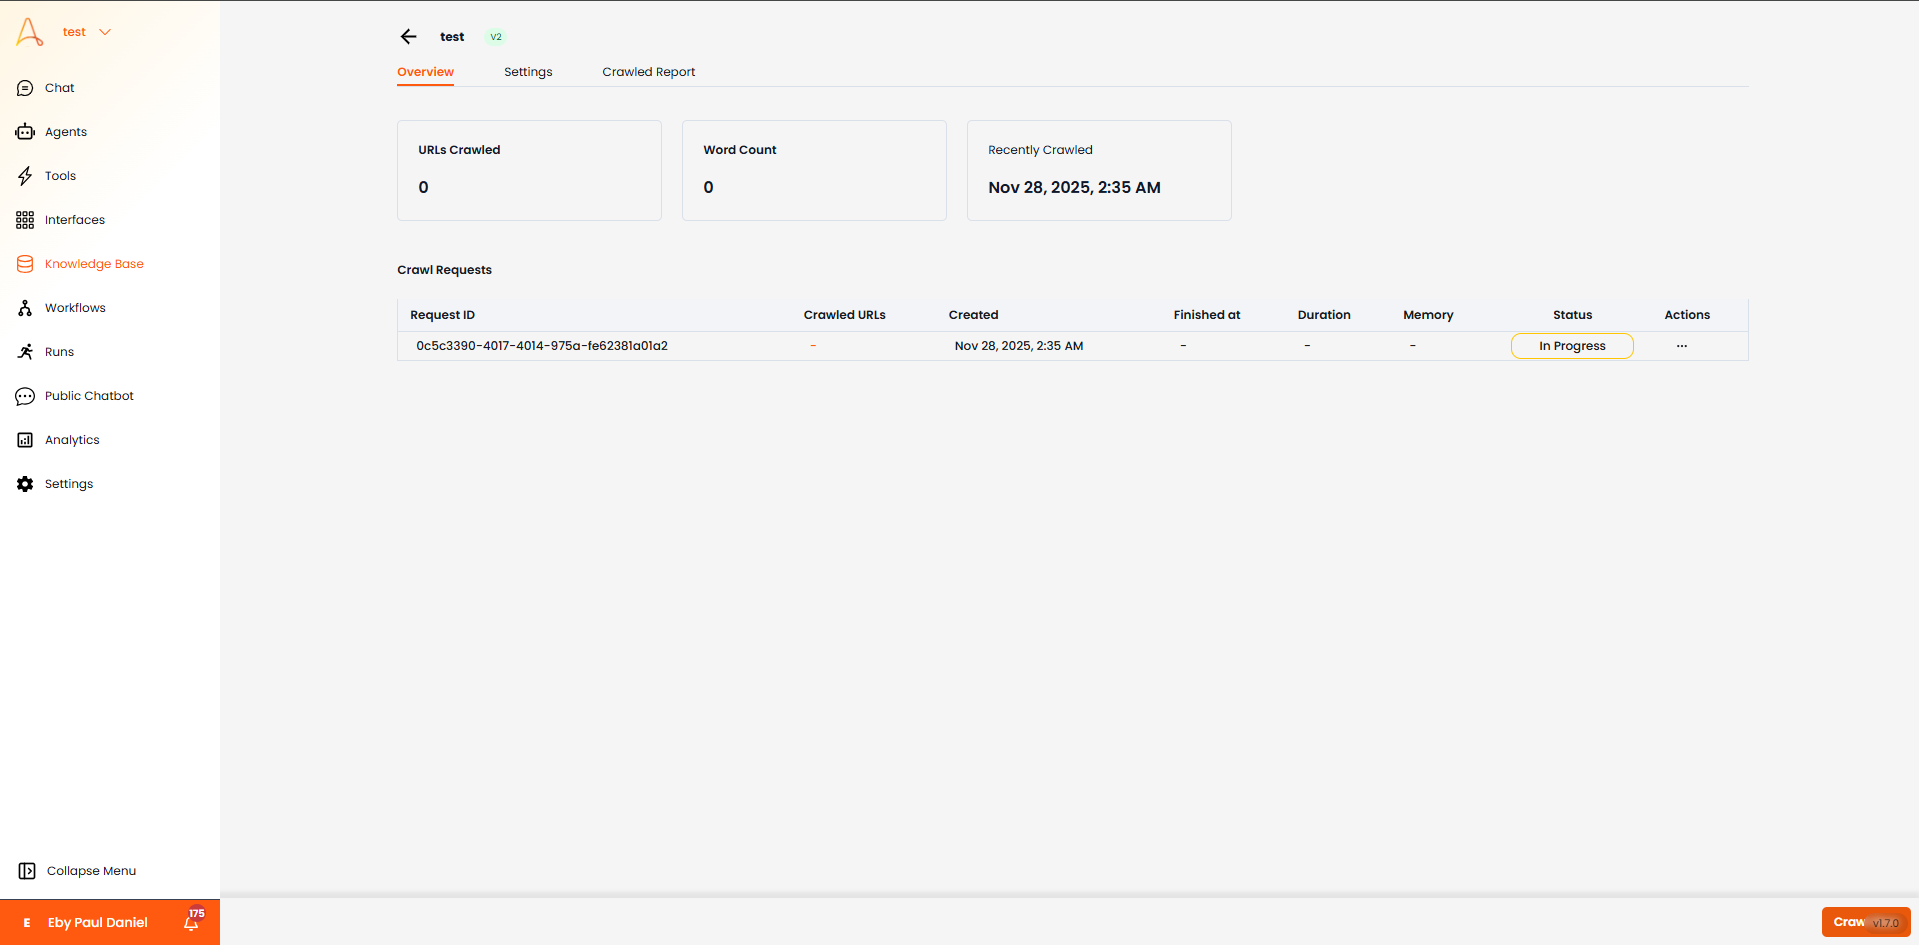
- Aperçu – C'est ici que vous pouvez voir les informations et l'état de la demande de crawl.
- Paramètres – C'est ici que vous pouvez modifier les paramètres du crawler. Vous pouvez modifier ces paramètres même après l'exécution d'un crawl.
- Rapport analysé – Cet onglet fournit des mises à jour en temps réel sur les pages en cours d'analyse.
Bonnes pratiques
1. Utilisez des URL de départ claires et concises
Choisissez des URL qui pointent directement vers la section du site Web que vous souhaitez extraire.
- Bon exemple :
https://www.example.com/news(cible uniquement la section « actualités ») - Mauvais exemple :
https://www.example.com?user=1234(L'utilisation de paramètres dynamiques peut causer des erreurs ou des crawls redondants)
Assurez-vous toujours :
- que l'URL est accessible et pertinente pour les données que vous souhaitez extraire.
- d'utiliser des sous-pages lorsque vous souhaitez restreindre le crawl à une section spécifique.
2. Restreindre aux domaines et sous-domaines
Gardez votre crawl concentré pour éviter de récupérer des données inutiles ou sans rapport.
- Limiter au domaine racine – Le crawl de
example.comcapture uniquement ce domaine et ignore les liens externes (p. ex., otherwebsite.com). - Limiter au domaine – Le crawl de
blog.example.comn'inclura pas d'autres sous-domaines commeshop.example.com.
Exemple
Le crawl de https://www.bbc.com, avec l'option Limiter au domaine racine activée garantit que seul le contenu BBC est inclus – pas les sources d'actualités externes liées sur le site.
3. Utilisez les modèles de crawl et de traitement
Les modèles vous permettent d'affiner ce que le crawler récupère et traite.
- Modèles de crawl – Définissez les URL qui doivent être analysées.
- Modèles de traitement – Spécifiez le contenu qui doit être extrait dans votre base de connaissances.
Les deux utilisent une syntaxe regex simplifiée :
- Caractère générique implicite – L'entrée de
productscorrespond à toute URL contenant « products ». - Négation(
!) –!productscorrespond à toute URL sans « products ». - Commence par (
^) –^https://example.com/products/correspond aux URL commençant par ce chemin. - Se termine par(
$) –products/$correspond aux URL se terminant par « products ».
Exemple
- Modèle de crawl –
https://example.com/products/*> analyse toutes les pages de produits. - Modèle de traitement –
https://example.com/products/*reviews> extrait uniquement les avis des pages de produits.
4. Activez les crawls planifiés (le cas échéant)
Pour les sites Web dynamiques, planifiez des crawls pour maintenir votre base de connaissances à jour.
Exemple
Suivez les prix des actions sur https://www.nasdaq.com en activant les crawls quotidiens.
5. Utilisez les sitemaps pour plus d'efficacité
Si un site offre un sitemap (p. ex., https://example.com/sitemap.xml), exploitez-le pour guider le crawler et assurer une couverture complète.
Exemple
Un site Web d'actualités avec un sitemap listant tous les articles récents garantit qu'aucun article n'est manqué.