웹 크롤러 사용
웹 크롤러를 사용하면 웹사이트의 도메인 URL을 사용하여 웹사이트에서 자동으로 정보를 수집할 수 있습니다. 도메인 내에서 발견할 수 있는 모든 페이지는 자동으로 지식 기반에 추가됩니다. 콘텐츠가 자주 업데이트되는 웹사이트의 경우 주기적인 크롤링을 예약하여 새로 추가된 페이지의 최신 정보와 콘텐츠를 지식 기반에 추가할 수 있습니다. 또한 크롤링 패턴 내에서 특정 키워드나 경로를 지정하여 웹사이트의 특정 섹션만 추출할 수 있습니다.
크롤링 패턴
패턴은 단순한 URL 문자열 일치를 기반으로 크롤링되거나 처리되는 페이지에 대한 빠르고 쉬운 제한을 가능하게 합니다. 예를 들어, http://www.example.com/sports/heres-a-sports-article.html에서 "sports" 카테고리 내의 페이지만 크롤링하려면 /sports/ 크롤링 패턴을 지정할 수 있습니다(슬래시를 포함하면 정확도가 보장되고 URL의 다른 위치에서 "sports" 문자열과의 일치를 피할 수 있습니다).
크롤링 패턴을 사용하면 크롤링을 특정 하위 도메인으로 제한할 수 있습니다. 예를 들어 특정 도메인에서 시작하는 크롤링에서 원하지 않는 링크의 크롤링을 방지하기 위해 크롤링 패턴을 입력할 수 있습니다. 웹 크롤 구성에서 각 개별 패턴을 새 줄에 배치하여 여러 문자열과 일치하는 여러 패턴을 입력할 수 있습니다.
사용 가능한 크롤링 패턴은 다음과 같습니다:
URL 시작 부분으로 일치 제한
캐럿 문자(^)를 사용하여 패턴 일치를 URL 시작 부분으로 제한합니다. 예를 들어 ^https://example.com 처리 패턴은 URL이 https://example.com으로 시작하는 페이지로만 처리를 제한합니다.
부정 일치 패턴
느낌표(!)를 사용하여 "부정 일치"로 페이지를 명시적으로 크롤링하거나 처리에서 제외합니다.
정규식 크롤링 및 처리
크롤링 또는 처리 URL 일치에 대한 정밀한 제어를 위해 정규식(regex)을 생성하여 정의된 식과 일치하는 URL만 독점적으로 크롤링하거나 처리할 수 있습니다. 예를 들어 https://example.com/의 "/crawl" 경로 아래에 "regex" 용어가 포함된 페이지를 처리하려면 \\/crawl.*?regex와 유사한 처리 정규식을 사용할 수 있습니다.
크롤봇은 페이지 평가 시 최적의 성능을 위해 사용자 지정 정규식 엔진을 사용합니다. 크롤봇 파싱에 일반적으로 사용되는 문자 클래스 구문과 관련하여 크롤봇은 모든 ASCII 처리 문자와 대부분의 Perl/Tcl 단축키를 지원합니다.
HTML 처리 패턴
크롤은 HTML 처리 패턴을 기반으로 처리되는 페이지를 제한할 수 있으며, 이는 크롤링 시 JavaScript/AJAX를 실행하지 않고 원본 소스만 검사합니다. 그러나 이 옵션의 단점은 크롤링 속도입니다. 더 빠른 크롤링 속도를 원한다면 정규식 크롤링 및 처리를 사용해야 합니다.
크롤러 사용 시점
크롤러는 웹에서 구조화되고 고품질의 정보를 추출하도록 설계되었습니다. 데이터가 공개적으로 사용 가능하고 정기적으로 업데이트되는 시나리오에서 가장 잘 작동합니다.
최적의 사용 사례
- 뉴스 및 미디어 – BBC News와 같은 사이트에서 기사 추출
- 금융 데이터 – NASDAQ과 같은 주식 사이트에서 시장 인사이트 수집
- 전자상거래 – 마켓플레이스에서 상품 목록, 리뷰 및 가격 수집
- 지식 리소스 – 블로그 게시물, 포럼 토론 또는 FAQ 콘텐츠를 캡처하여 지식 기반을 풍부하게 합니다.
크롤러를 사용하지 말아야 할 시점
오류나 규정 준수 문제를 방지하기 위해 이러한 상황에서는 크롤링을 피하세요:
- 인증 필요 – 로그인 자격 증명이 필요한 웹사이트(예: LinkedIn).
- 고도로 역동적인 대시보드 – 실시간 대시보드(예: 실시간 주식 시세)는 완전한 결과를 제공하지 못할 수 있습니다.
- 과도한 사이트 부하 – 각 사이트의 사용 정책을 존중하세요–크롤링 전에 항상
robot.txt파일을 검토하세요.
새 크롤러 만들기
- EKB 프로젝트에서 지식 기반으로 이동합니다.
- 지식 기반에서 오른쪽 상단의 톱니바퀴 아이콘을 클릭합니다.
- 크롤러 탭으로 이동합니다.
- + 새로 만들기를 클릭합니다.
- 입력 섹션:
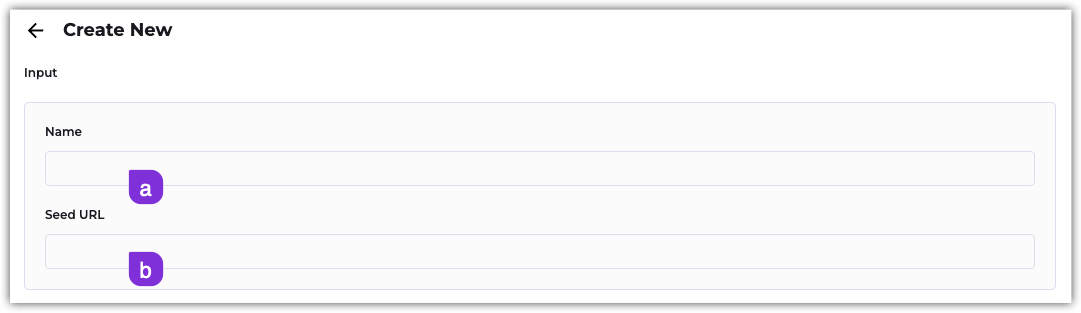 a. 크롤러의 이름을 입력합니다.
b. 크롤링할 웹사이트에 대한 시드 URL을 제공합니다. 이는 크롤러에 의해 접근되는 초기 링크입니다. 여기서 크롤러는 웹사이트 내에서 사용 가능한 웹 페이지와 링크를 탐색합니다. - 크롤러 설정 섹션:
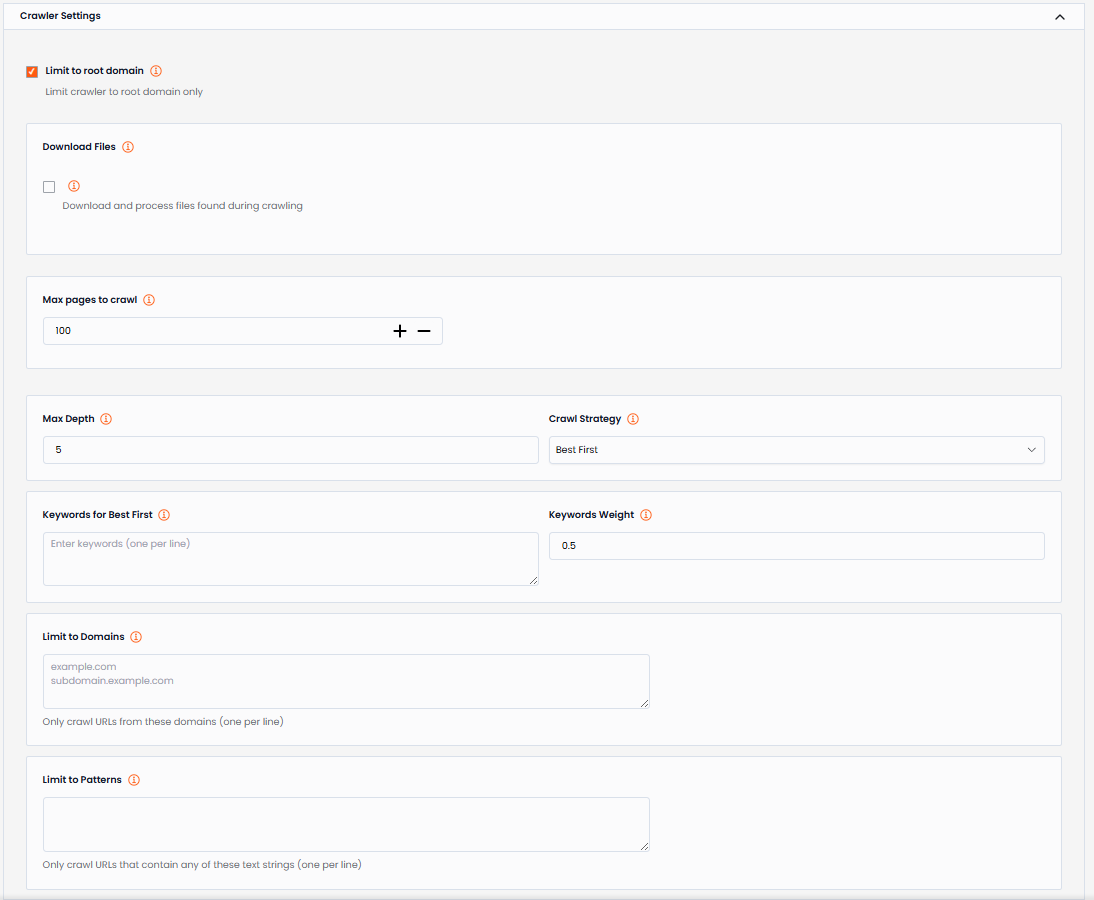
- 루트 도메인으로 제한 – 크롤러가 루트 도메인에만 집중하도록 설정하여 관련 정보 추출을 간소화합니다.
- 파일 다운로드 – 크롤링 중 발견된 파일을 다운로드하고 처리하려면 이 옵션을 활성화합니다.
- 최대 크롤링 페이지 수 – 리소스 사용 및 효율성을 최적화하기 위해 크롤링할 최대 페이지 수를 설정합니다.
- 최대 깊이 – 시드 URL에서 크롤링할 최대 깊이를 설정합니다(즉, 따라갈 링크의 깊이).
- 크롤 전략 – 크롤러가 어떤 페이지를 먼저 방문할지 우선순위를 정하는 방법을 선택합니다.
- 최적 우선 – 이 옵션을 선택하면 크롤러가 이러한 페이지를 찾기 위해 사용해야 하는 키워드와 이 키워드의 가중치를 구성해야 합니다.
- 최적 우선용 키워드 – 이 텍스트 상자에 구성된 키워드가 포함된 페이지가 먼저 크롤링됩니다. 줄당 하나의 키워드를 입력합니다.
- 키워드 가중치 – 키워드 일치를 위한 키워드 가중치를 구성합니다. 값이 높을수록 키워드 일치가 우선시됩니다.
- 폭 우선 – 이 방법은 더 깊이 탐색하기 전에 현재 페이지에서 직접 연결된 모든 페이지를 먼저 방문하는 것을 우선시합니다.
- 깊이 우선 – 이 방법은 다른 경로를 탐색하기 전에 단일 링크 경로를 따라 최대한 깊이 탐색하는 것을 우선시합니다.
- 최적 우선 – 이 옵션을 선택하면 크롤러가 이러한 페이지를 찾기 위해 사용해야 하는 키워드와 이 키워드의 가중치를 구성해야 합니다.
- 도메인으로 제한 – 루트 도메인 내의 모든 하위 도메인 대신 크롤러를 특정 도메인으로 제한합니다. 줄당 하나의 도메인을 입력하거나 비워 두면 모든 하위 도메인이 크롤링됩니다.
- 패턴으로 제한 – 크롤러가 사용할 크롤링 패턴을 입력합니다. 줄당 하나의 크롤링 패턴을 입력합니다.경고여러 크롤링 패턴을 사용하는 경우 다음 계층이 적용됩니다:
1. 정규식
2. 부정 일치
3. 모든 다른 패턴.
- 예약 섹션에서 예약된 크롤링의 빈도와 시간을 정의합니다:
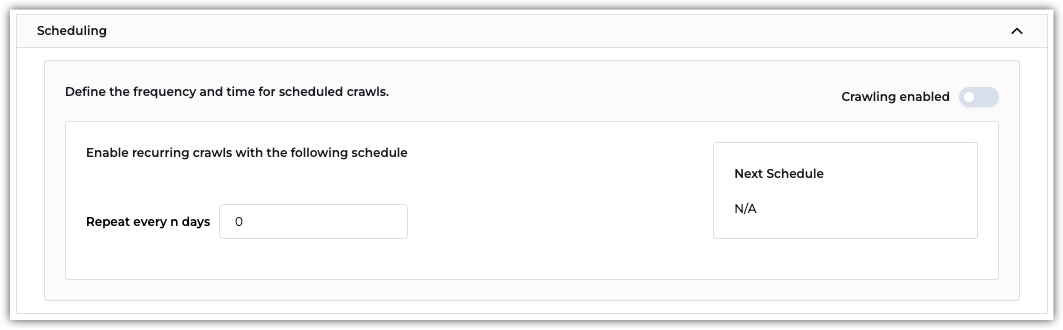
- 크롤링 활성화 – 크롤링 예약을 설정하려면 이 옵션을 활성화합니다.
- n일마다 반복 – 크롤링을 실행할 일수를 설정합니다. 예를 들어:
- 매일 =
1 - 매주 =
7 - 격주 =
14 - 매월 =
30
- 매일 =
- 다음 예약 – 입력한 일수에 따라 다음 크롤링 날짜가 표시됩니다.
- 웹 크롤 구성을 완료한 후 지금 크롤링을 클릭하여 첫 번째 크롤링을 시작합니다. 다음 탭이 포함된 새 크롤러 구성 페이지로 리디렉션됩니다:
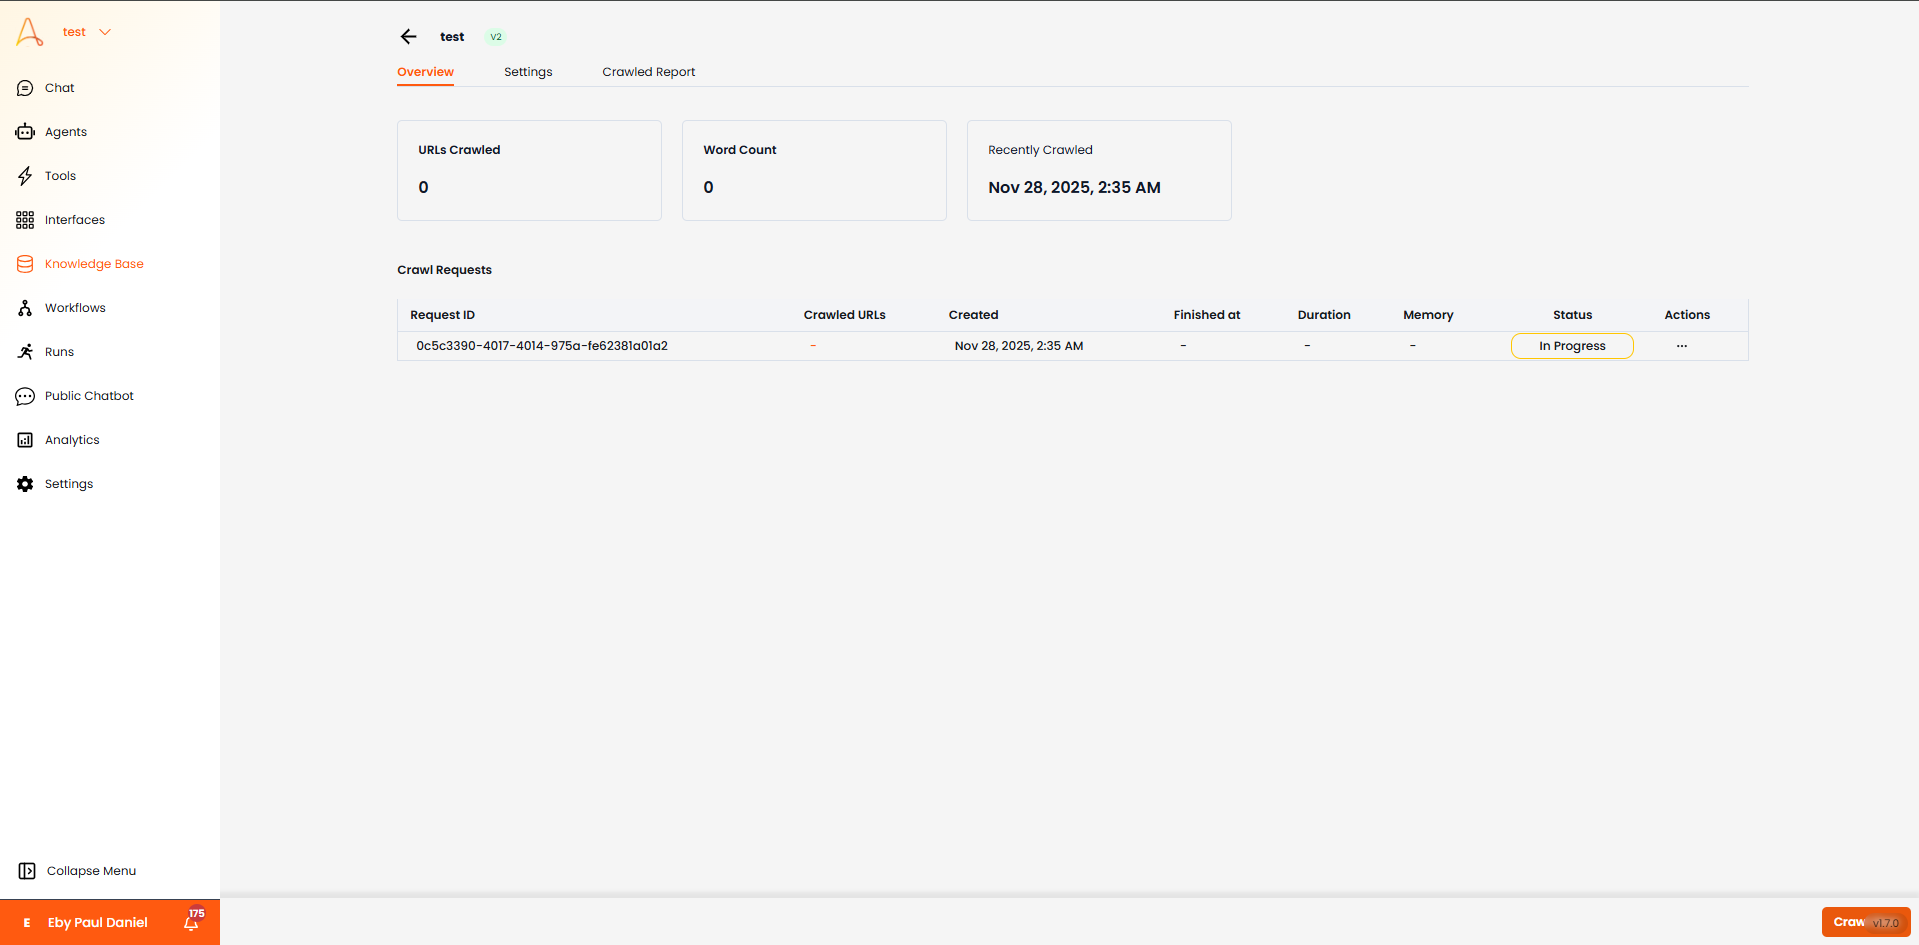
- 개요 – 크롤링 요청 정보와 상태를 볼 수 있는 곳입니다.
- 설정 – 크롤러 설정을 편집할 수 있는 곳입니다. 크롤링이 실행된 후에도 이 설정을 편집할 수 있습니다.
- 크롤링 보고서 – 이 탭은 크롤링되는 페이지에 대한 실시간 업데이트를 제공합니다.
모범 사례
1. 명확하고 간결한 시드 URL 사용
추출하려는 웹사이트 섹션을 직접 가리키는 URL을 선택하세요.
- 좋은 예시:
https://www.example.com/news("뉴스" 섹션만 대상) - 나쁜 예시:
https://www.example.com?user=1234(동적 매개변수를 사용하면 오류나 중복 크롤링이 발생할 수 있음)
항상 다음을 확인하세요:
- URL에 접근 가능하고 추출하려는 데이터와 관련이 있는지 확인
- 크롤링을 특정 섹션으로 제한하려면 하위 페이지 사용
2. 도메인 및 하위 도메인으로 제한
불필요하거나 관련 없는 데이터를 가져오지 않도록 크롤링을 집중하세요.
- 루트 도메인으로 제한 –
example.com을 크롤링하면 해당 도메인만 캡처하고 외부 링크(예: otherwebsite.com)는 무시합니다. - 도메인으로 제한 –
blog.example.com을 크롤링하면shop.example.com과 같은 다른 하위 도메인이 포함되지 않습니다.
예시
https://www.bbc.com을 크롤링할 때 루트 도메인으로 제한을 활성화하면 사이트에 링크된 외부 뉴스 소스가 아닌 BBC 콘텐츠만 포함됩니다.
3. 크롤링 및 처리 패턴 사용
패턴을 사용하여 크롤러가 가져오고 처리하는 것을 미세 조정할 수 있습니다.
- 크롤링 패턴 – 어떤 URL을 크롤링해야 하는지 정의합니다.
- 처리 패턴 – 어떤 콘텐츠를 지식 기반으로 추출해야 하는지 지정합니다. 둘 다 간소화된 정규식 구문을 사용합니다:
- 암시적 와일드카드 –
products를 입력하면 "products"가 포함된 모든 URL과 일치합니다. - 부정(
!) –!products는 "products"가 없는 모든 URL과 일치합니다. - 시작(
^) –^https://example.com/products/는 해당 경로로 시작하는 URL과 일치합니다. - 끝(
$) –products/$는 "products"로 끝나는 URL과 일치합니다.
예시
- 크롤링 패턴 –
https://example.com/products/*> 모든 상품 페이지를 크롤링합니다. - 처리 패턴 –
https://example.com/products/*reviews> 상품 페이지에서 리뷰만 추출합니다.
4. 예약된 크롤링 활성화 (필요한 경우)
동적 웹사이트의 경우 지식 기반을 최신 상태로 유지하기 위해 크롤링을 예약하세요.
예시
https://www.nasdaq.com에서 매일 크롤링을 활성화하여 주식 가격을 추적하세요.
5. 사이트맵을 사용하여 효율성 향상
사이트가 사이트맵(예: https://example.com/sitemap.xml)을 제공하는 경우 이를 활용하여 크롤러를 안내하고 완전한 범위를 보장하세요.
예시
최신 기사를 모두 나열하는 사이트맵이 있는 뉴스 웹사이트는 기사가 하나도 누락되지 않도록 보장합니다.